Apri una email, un file o una pagina web e, al posto di “perché”, leggi “perché”. Al posto di “è”, una strana coppia: “è”. Il testo sembra rotto, ma non lo è: ogni lettera è ancora lì, intatta.
È successo un malinteso. Chi ha scritto il testo e chi lo legge usano due “dizionari” diversi per trasformare i numeri in lettere. Capire come funzionano ASCII, Unicode e UTF-8 è il modo più semplice per non vedere mai più questi caratteri, e per sistemarli quando compaiono.
In questa guida ti spiego tutto senza formule: cosa sono, come lavorano insieme e cosa controllare, passo per passo, per eliminare i caratteri sbagliati. Con un ispettore che ti mostra i byte di qualsiasi testo.
Il problema in breve: il computer conosce solo numeri
Un computer non sa cos’è una lettera. Conserva solo numeri, e per mostrare un testo usa una tabella che dice “il numero 65 è la A, il 66 è la B”. Questa tabella si chiama codifica, in inglese encoding.
Finché chi scrive e chi legge usano la stessa tabella, tutto funziona. Se le tabelle sono diverse, gli stessi numeri diventano lettere diverse. È questo il motivo di quasi tutti i caratteri strani che vedi.
ASCII: la prima tabella
Nel 1963 nasce ASCII, la tabella che per decenni è stata la base di tutto. Contiene 128 caratteri: le lettere inglesi maiuscole e minuscole, le cifre, la punteggiatura e alcuni comandi invisibili, come l’a capo.
| Carattere | Numero decimale | Esadecimale |
|---|---|---|
| Spazio | 32 | 20 |
0 | 48 | 30 |
A | 65 | 41 |
a | 97 | 61 |
Il limite si vede subito: niente “è”, niente “ñ”, niente “€”. ASCII bastava per l’inglese, non per il resto del mondo.
Il caos delle tabelle locali
Per aggiungere le lettere accentate, ogni area del mondo ha creato la sua tabella estesa, con 256 caratteri invece di 128. In Europa occidentale si usavano soprattutto ISO 8859-1, detta anche Latin-1, e la sua variante di Windows, Windows-1252.
Il problema è che ogni tabella usava gli stessi numeri per lettere diverse. Lo stesso byte poteva essere una “è” in Italia e una lettera greca in Grecia. Un file scritto con una tabella e letto con un’altra diventava illeggibile.
Unicode: un numero per ogni carattere
Unicode nasce per chiudere il caos: un’unica tabella per tutti i caratteri di tutte le lingue. Oggi contiene più di 150.000 caratteri, dalle lettere latine agli ideogrammi cinesi, dai simboli matematici alle emoji, e ha spazio per oltre un milione.
Ogni carattere ha il suo numero, chiamato code point, che si scrive così: U+00E8. Il numero dopo U+ è in esadecimale. È lo stesso che hai incontrato nelle entità HTML come è e nelle sequenze di escape come \u00E8: cambia il modo di scriverlo, non il numero.
Nota
Unicode è un elenco: dice quale numero ha ogni carattere. Non dice come quel numero vada salvato in un file. Per quello serve una codifica, ed è qui che entra in gioco UTF-8.
UTF-8: come si salvano i numeri in byte
Un byte può contenere solo i numeri da 0 a 255, mentre Unicode arriva a più di un milione. UTF-8 risolve il problema in modo elegante: usa da 1 a 4 byte, a seconda del carattere.
- 1 byte per i 128 caratteri di ASCII. Un testo in inglese salvato in UTF-8 è identico allo stesso testo in ASCII.
- 2 byte per le lettere accentate europee, come “è”, e per i caratteri greci, cirillici, ebraici e arabi.
- 3 byte per quasi tutto il resto, compreso il simbolo “€” e gli ideogrammi.
- 4 byte per la maggior parte delle emoji e per i caratteri più rari.
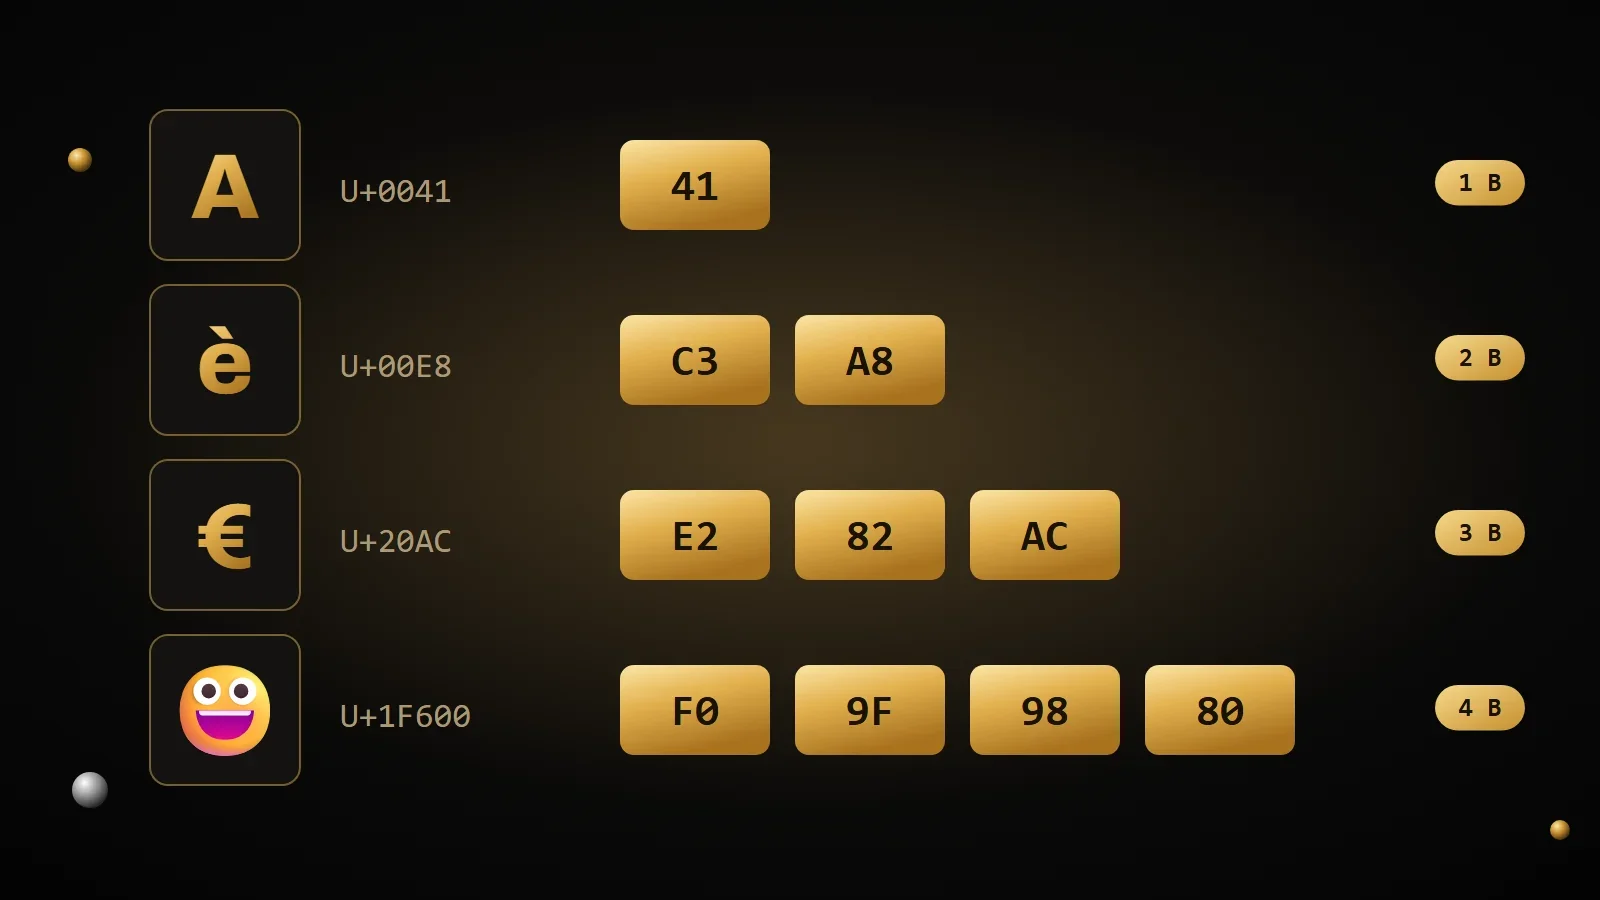
È per questo che UTF-8 ha vinto: è compatibile con ASCII, non spreca spazio e può scrivere qualsiasi carattere. A ottobre 2026 lo usa il 99,1% dei siti web di cui si conosce la codifica, secondo W3Techs.
Perché un’emoji “vale” due caratteri
Prova in JavaScript: "😀".length restituisce 2, non 1. JavaScript conserva il testo in UTF-16, un’altra codifica di Unicode che usa unità da 2 byte, e un’emoji ne occupa due. Per contare i caratteri come li vede una persona, usa [..."😀"].length, che restituisce 1.
Perché la “è” diventa “è”
Ora hai tutti i pezzi. La “è” in UTF-8 occupa due byte: C3 e A8. Se un programma legge quei byte credendo che il testo sia in Windows-1252, li trasforma in due caratteri separati: C3 è “Ã” e A8 è “¨”.
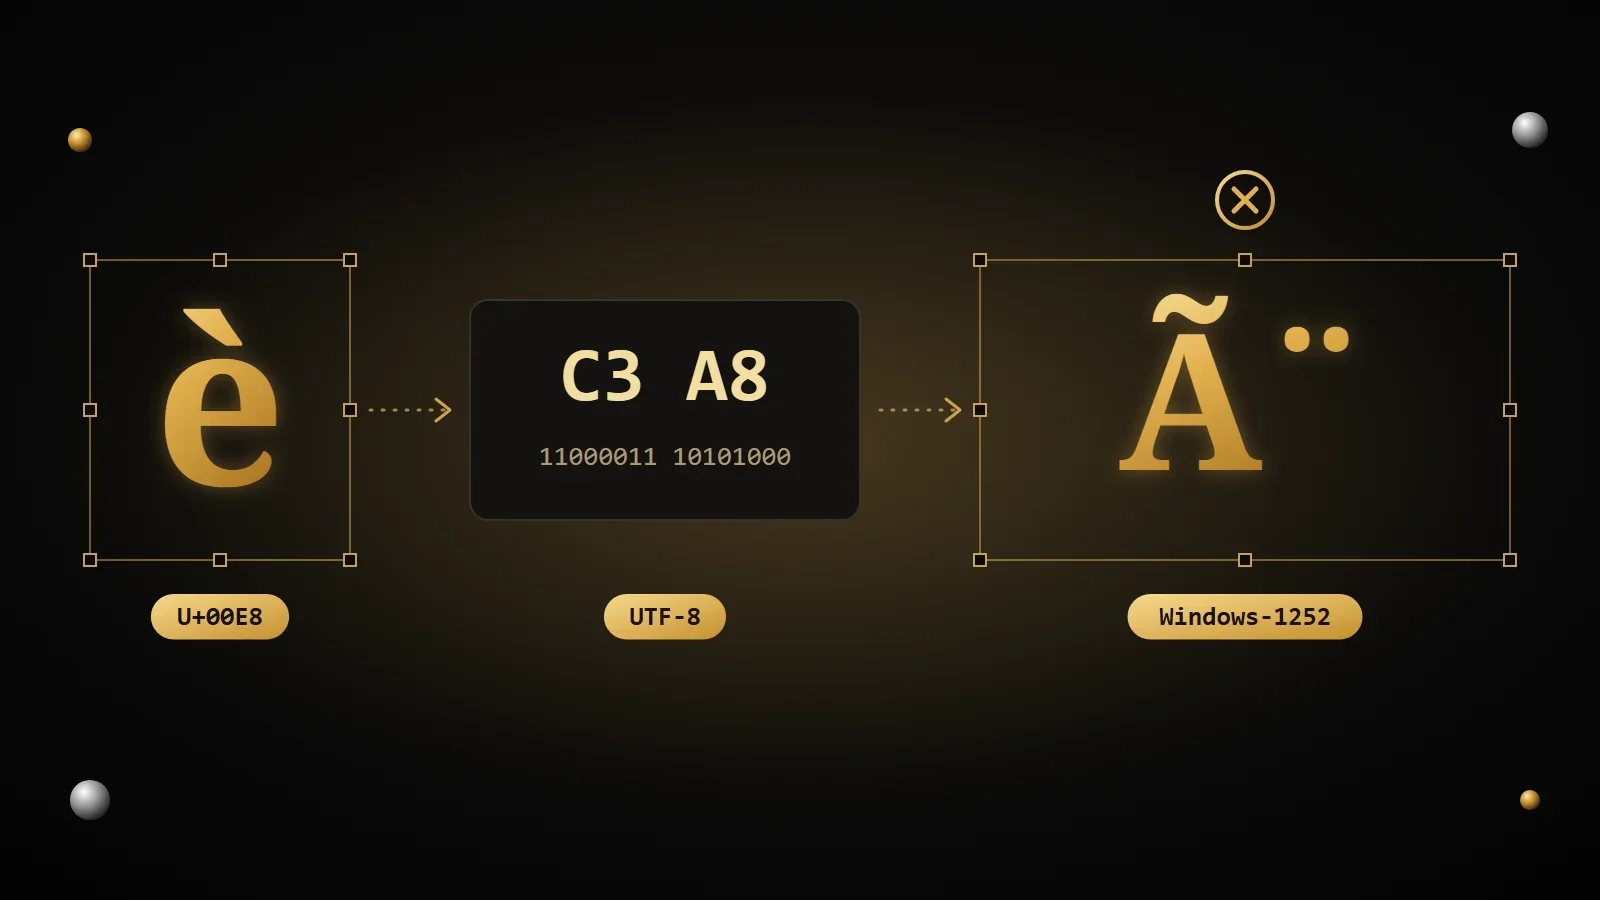
Questo errore ha anche un nome: mojibake, una parola giapponese che indica proprio i caratteri trasformati. Ecco quelli che incontrerai più spesso. Se li riconosci, sai già cos’è successo: un testo UTF-8 letto come Windows-1252.
| Dovevi leggere | Byte in UTF-8 | Leggi invece |
|---|---|---|
| è | C3 A8 | è |
| é | C3 A9 | é |
| à | C3 A0 | Ã seguito da uno spazio invisibile |
| ò | C3 B2 | ò |
| ù | C3 B9 | ù |
| € | E2 82 AC | € |
| ’ (apostrofo tipografico) | E2 80 99 | ’ |
Succede anche il contrario. Se un testo salvato in Windows-1252 viene letto come UTF-8, le lettere accentate diventano “�”, un rombo con il punto interrogativo: è il carattere che il programma usa quando trova byte che non hanno senso in UTF-8.
Prova l’ispettore di caratteri
Scrivi o incolla un testo qualsiasi: vedi il numero Unicode di ogni carattere, i suoi byte in UTF-8 e come diventerebbe se venisse letto per errore come Windows-1252. Prova con le tue parole accentate, o con un’emoji.
Ispettore di caratteri
Scrivi o incolla un testo qualsiasi: vedrai il codice Unicode di ogni carattere, i suoi byte in UTF-8 e come diventa se viene letto con la codifica sbagliata.
| Carattere | Unicode | UTF-8 | HTML | JavaScript |
|---|
Come eliminare per sempre i caratteri sbagliati
La regola d’oro è una sola: UTF-8 ovunque. Basta un passaggio che usa una codifica diversa per rovinare il testo, quindi controlla ogni anello della catena.
1. Salva i file in UTF-8
Negli editor moderni, come Visual Studio Code, la codifica è scritta in basso a destra. Se vedi un’altra codifica, usa “Salva con codifica” e scegli UTF-8.
2. Dichiara la codifica nella pagina
Il tag meta va messo all’inizio dell’head: lo standard HTML chiede che stia per intero nei primi 1024 byte della pagina.
<!doctype html>
<html lang="it">
<head>
  <meta charset="utf-8">
  <title>La mia pagina</title>
</head>
3. Controlla cosa dice il server
Il server invia insieme alla pagina un’intestazione che indica la codifica, e se c’è vale più del tag meta. Deve dire charset=utf-8. In PHP puoi impostarla così, prima di stampare qualsiasi cosa:
<?php
header('Content-Type: text/html; charset=utf-8');
4. Usa utf8mb4 nel database
In MySQL e MariaDB la vecchia codifica chiamata utf8 salva al massimo 3 byte per carattere, quindi niente emoji. Quella completa si chiama utf8mb4: usala per le tabelle e anche per la connessione.
ALTER TABLE articoli CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;
SET NAMES utf8mb4;
5. Attenzione ai file CSV con Excel
Excel apre spesso i file CSV con la vecchia codifica di Windows, e le lettere accentate si rovinano. Quando salvi da Excel scegli “CSV UTF-8”; quando apri un CSV, importalo dal menu Dati indicando l’origine UTF-8.
Consiglio
Il testo è già rovinato? Se il problema è sempre lo stesso, si può fare il percorso al contrario. In Python, per esempio, applichi al testo rovinato .encode("cp1252") e poi .decode("utf-8"): “perché” torna a essere “perché”. Fai sempre una copia di sicurezza prima di correggere un database.
Domande frequenti
Che differenza c’è tra Unicode e UTF-8?
Unicode è l’elenco che dà un numero a ogni carattere. UTF-8 è il modo di salvare quei numeri in byte. Di solito si usano insieme: testo Unicode salvato in UTF-8.
ASCII e UTF-8 sono compatibili?
Sì. I 128 caratteri di ASCII in UTF-8 occupano un byte ciascuno, con gli stessi numeri. Un file che contiene solo caratteri ASCII è già, automaticamente, un file UTF-8 valido.
Perché vedo é al posto di é?
Perché un testo salvato in UTF-8 viene letto come Windows-1252 o Latin-1. Controlla la dichiarazione charset della pagina, l’intestazione inviata dal server e la codifica del database o del file.
Cos’è il rombo con il punto interrogativo �?
È il “carattere di sostituzione” di Unicode, U+FFFD. Il programma lo mostra quando trova byte che non formano un carattere valido, per esempio un testo in Windows-1252 letto come UTF-8.
Cos’è UTF-8 con BOM?
È un file UTF-8 che inizia con tre byte speciali, EF BB BF, usati da alcuni programmi per riconoscere la codifica. Per le pagine web e il codice è meglio senza: in PHP, per esempio, quei byte possono finire in pagina come spazi o caratteri strani.
Quale codifica devo usare?
UTF-8, sempre: per le pagine, i file, i database e le email. È lo standard del web e l’unica che gestisce tutte le lingue senza problemi.
Fonti e approfondimenti
- Unicode: domande frequenti su UTF-8, UTF-16 e BOM
- RFC 3629: la specifica di UTF-8
- WHATWG: dichiarare la codifica in HTML
- W3C: dichiarare la codifica dei caratteri in HTML
- MDN Web Docs: UTF-8
- W3Techs: le codifiche usate dai siti web
Ora sai perché la “è” diventa “è”, e come evitarlo. Quei due byte, C3 e A8, li ritrovi anche dove non te li aspetti: negli indirizzi delle pagine, scritti come %C3%A8. Nel prossimo articolo ti spiego l’URL encoding, cosa significa %20 e come codificare correttamente un link.
Commenti
Nessun commento. Lascia il primo!
Lascia un commento